Kessel (SpaceX 客製化 AI 機櫃)
時間軸
- 2026/11/13:
- 孟恭揭露 Kessel 更多硬體情報,定位為 Compact NVL72,以 AI 推論為主,規劃先部署地面資料中心,再評估太空軌道運算。
- 補充機櫃尺寸、正反面托盤排列、M10 搭配 Q-glass、連接器、電源及散熱等設計,尚未獲 SpaceX 官方確認。
- 2026/11/11:
定義
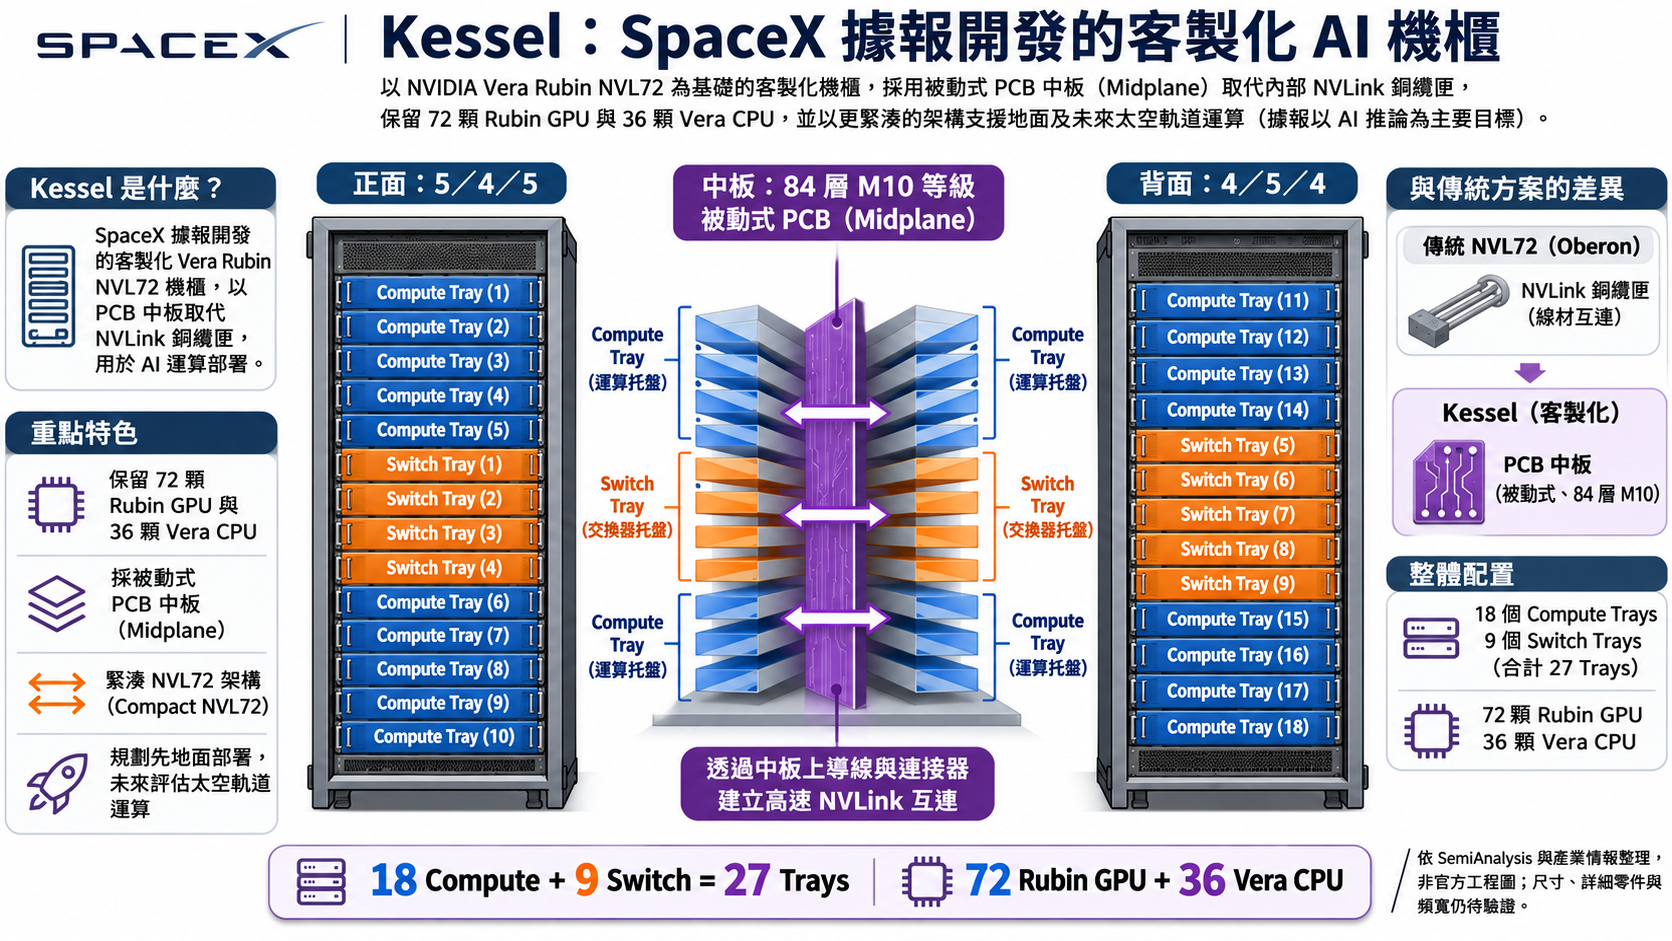
- SpaceX 客製化 AI 機櫃:是 SpaceX 據報正在開發、以 NVIDIA Vera Rubin NVL72 為基礎,透過被動式 PCB 中板取代內部 NVLink 銅纜匣的緊湊型 AI 運算系統,規劃用於地面及未來太空軌道運算。
設計定位
- 緊湊型 NVL72:保留 NVIDIA Oberon 的主要運算配置,借鑑 Kyber 的中板互連概念,重新設計機櫃結構。
- 推論優先:根據孟恭情報,主要針對 AI Inference 工作負載進行最佳化,但不代表完全無法執行模型訓練。
- 自主設計:SpaceX 希望減少對 NVIDIA 完整板卡與機櫃方案的依賴,取得零組件、散熱、供電及系統整合的主導權。
- 先地面、後太空:規劃先在地面資料中心驗證系統,未來再評估將運算設備部署至太空軌道。
- 地面部署:便於驗證高速互連、散熱、供電、系統穩定性及維修能力。
- 太空部署:除了運算效率,還必須解決發射重量、電力供應、輻射防護、真空環境散熱及遠端維修等問題。
- 開發狀態:截至 2026/11/13,尚未取得 SpaceX 官方完整規格、量產時程及實際部署成果。
機櫃構造
- GPU 配置:72 顆 NVIDIA Rubin GPU,搭配 36 顆 Vera CPU。
- Compute Tray:18 個運算托盤,每個配置 4 顆 Rubin GPU、2 顆 Vera CPU。
- Switch Tray:9 個 NVLink 交換器托盤,負責機櫃內 GPU 之間的高速資料交換。
- PCB 中板:採用中央被動式中板 (Passive Midplane),運算托盤與交換器托盤背對背排列在中板兩側。
- 機櫃尺寸:孟恭估計約 1.0 m × 0.5 m × 0.4 m,尚未確認尺寸方向及最終機構規格。
正反面配置
- 正面:5 個 Compute Tray、4 個 Switch Tray、5 個 Compute Tray,合計 14 個托盤。
- 背面:4 個 Compute Tray、5 個 Switch Tray、4 個 Compute Tray,合計 13 個托盤。
- 總計:18 個 Compute Tray、9 個 Switch Tray,共 27 個托盤。
- 背對背設計:兩側托盤共用中央 PCB 中板進行高速訊號互連,而非兩套獨立運算系統。
- 主要目的:透過重新安排托盤與訊號路徑,降低內部銅纜配置的複雜度,並提高機構設計的緊湊程度。
- 配置限制:正反面 5/4/5、4/5/4 的排列方式來自產業情報,並非正式工程圖。
核心技術:PCB 中板
- 傳統 Oberon:透過 NVLink 被動式銅纜匣連接 Compute Tray 與 Switch Tray。
- Kessel:使用 PCB 中板上的高速銅導線及連接器傳輸訊號,取代原本部分內部 NVLink 銅纜連接。
- 被動式設計:中板本身不負責 GPU 運算或資料交換決策,主要提供高速訊號傳輸路徑,實際交換功能仍由 NVSwitch 執行。
- PCB 層數:SemiAnalysis 指出 Kessel 採用 84 層中板,較早期 Kyber 規劃的 156 層減少 72 層。
- M10 (Megtron 10):Panasonic 的超低損耗高速 PCB 材料系列,適合高頻、高速訊號傳輸;SemiAnalysis 指出 Kessel 採用 M10 等級材料。
- Q-glass (Quartz Glass):石英玻璃纖維布,具備低 介電常數 與低介電損耗等特性;孟恭指出 Kessel 採用 M10 搭配 Q-glass。
- Amphenol Paladin:Amphenol 的高速背板/中板連接器系列,孟恭指出 Kessel 使用該方案進行高速訊號連接。
- 製造挑戰:高層數 PCB 需精確控制層間對位、鑽孔、阻抗及訊號損耗,避免高速傳輸時產生反射、串音與訊號衰減。
- 良率 問題:層數越多,通常會增加製造與檢測難度;84 層設計可能比 156 層更容易量產,但不保證良率或成本一定較佳。
運算與交換器托盤
Compute Tray (運算托盤)
- Strata 架構:據孟恭情報,採用單片式主板 (Monolithic Board),整合運算、記憶體、儲存及管理功能。
- 4G2C:每托盤配置 4 顆 Rubin GPU、2 顆 Vera CPU。
- SOCAMM:採壓接式連接的低功耗記憶體模組,主要提供 CPU 系統記憶體。
- E1.S:據報每托盤配置 8 顆 E1.S SSD,提供本地儲存空間。
- ConnectX-9 (CX-9):據報每托盤配置 2 顆,提供高速外部網路互連。
- OSFP:據報每托盤配置 2 個高速可插拔網路連接埠。
- RJ45:據報每托盤配置 1 個連接埠,供管理或其他有線通訊使用。
- BMC (Baseboard Management Controller):負責硬體健康監控、遠端管理及故障診斷。
- MCU (Microcontroller Unit):據報每托盤配置 5 顆,用於特定硬體控制及管理任務。
Switch Tray (交換器托盤)
- Rosalind NVLink Switch:據報沿用現有交換器技術,重新設計封裝及托盤結構。
- QM4:據報每托盤配置 4 顆 NVSwitch 晶片,9 個托盤合計 36 顆。
- x86 COMe (Computer-on-Module Express):採用 x86 架構的模組化電腦,用於交換器系統管理及控制。
- BMC:負責交換器托盤的監控、遠端管理及故障處理。
- 規格限制:Kessel 專屬的 E1.S、MCU、OSFP、QM4 等配置仍屬產業情報;NVIDIA 官方標準 NVL72 規格不能直接視為 Kessel 的最終規格。
高速互連架構
- Scale-up:透過 NVLink 與 NVSwitch 連接機櫃內 GPU,讓多顆 GPU 能以高頻寬、低延遲方式協同運算。
- Scale-out:透過 ConnectX-9、OSFP 及外部網路交換器連接不同機櫃,擴展 AI 運算叢集。
- Scale-up 頻寬:孟恭指出 Kessel 的 NVLink 頻寬約為標準版一半,尚未獲官方確認。
- Scale-out 頻寬:據報每顆 Rubin GPU 為 800G,低於標準版,但仍需確認頻寬單位與單向、雙向計算口徑。
- SerDes (Serializer/Deserializer):將平行資料轉換為高速序列訊號,並在接收端還原,是 NVLink 等高速互連技術的重要元件。
- TX / RX:分別代表發送與接收,孟恭描述 Kessel 使用 TX、RX 各一對差動訊號線。
- 單工爭議:原始情報稱 NVLink SerDes 改採單工,但 TX、RX 各一對線並不等同於單工 (Simplex);目前不足以據此確認實際傳輸模式或頻寬減半原因。
- 效能取捨:若頻寬降低的情報成立,Kessel 可能犧牲部分 GPU 互連效能,換取更緊湊的系統配置,但實際收益尚未量化。
電源與散熱
- 高壓電源板:孟恭指出 Kessel 將 400 VAC 轉換成不同托盤所需的直流電壓。
- Compute Tray:據報採用 12 VDC 供電。
- Switch Tray:據報採用 54 VDC 供電。
- Molex Sentrality:Molex 的高電流電源連接器系列,據報用於機櫃內部配電。
- 單片式冷板 (Monolithic Cold Plate):據報採用 液冷 設計,讓冷卻液透過冷板帶走晶片熱量。
- 散熱挑戰:緊湊化可能提高單位體積熱密度,必須評估冷板設計、冷卻液流量、熱阻及整體散熱能力。
與 NVIDIA 架構比較
| 項目 |
Oberon (標準 NVL72) |
Kessel |
Kyber (早期規劃) |
| 設計主導 |
NVIDIA |
SpaceX |
NVIDIA |
| 設計定位 |
標準 NVL72 機櫃 |
緊湊客製化 NVL72 |
新世代高密度架構 |
| GPU 數量 |
72 |
72 |
不同規模設計 |
| Compute Tray |
18 |
18 |
不同架構 |
| Switch Tray |
9 |
9 |
不同架構 |
| 高速互連 |
NVLink 銅纜匣 |
被動式 PCB 中板 |
PCB 中板/背板 |
| 中板層數 |
不適用 |
84 層 |
156 層 |
| 中板材料 |
不適用 |
M10 等級 |
M9 等級 |
| 機櫃內互連頻寬 |
標準 NVLink 6 |
據報約一半 |
不同規格 |
- 比較基準:Kyber 的 156 層 M9 來自 SemiAnalysis 引述的早期設計,並非最終量產規格。
- 技術差異:Kessel 不以減少 GPU 數量為主要特色,而是重新設計內部高速互連、托盤配置及採購方式。
- 製造取捨:Kessel 以較少的 PCB 層數搭配更高等級材料,嘗試降低中板的實際製造難度。
採購策略與供應鏈
- NVIDIA:SpaceX 據報計畫直接採購 GPU、CPU 等核心晶片封裝,跳過 NVIDIA 既有 L6 運算板。
- L6 (Board-Level Assembly):板卡裝配層級;不採用既有 L6 板卡,意味 SpaceX 必須承擔更多板卡設計、零組件採購及測試驗證責任。
- 高階 PCB:84 層 M10 中板提高對高階 CCL、玻纖布、精密鑽孔、層壓及訊號完整性製程的要求。
- Amphenol:Paladin 為產業人士提及的高速中板連接器方案。
- Molex:Sentrality 為產業人士提及的高電流電源連接方案。
- 供應鏈自主化:SpaceX 可自行決定更多零組件供應商、板卡規格及系統整合方式,降低對 NVIDIA 完整系統方案的依賴。
- 成本取捨:自行採購可能降低部分整合成本,但也會增加研發、製造、驗證、供應鏈管理及維修責任。
- 供應商限制:提及 M10、Q-glass、Paladin、Sentrality 不等於已確認相關廠商取得訂單或開始出貨。
技術挑戰與投資觀察
- 中板量產良率:84 層 PCB 能否穩定製造,是 Kessel 從設計走向量產的主要變數。
- 高速訊號完整性:須驗證長距離 PCB 走線的插入損耗、反射、串音及連接器可靠性,確保 NVLink 能穩定運作。
- 頻寬與推論效能:若 Scale-up 頻寬確實下降,需要評估是否影響跨 GPU 通訊密集型工作負載的效率。
- 維修與可靠性:中板有助於簡化部分內部配線,但大型中板發生故障時,可能提高維修難度與更換成本。
- 地面與太空部署:太空環境對散熱、供電、輻射防護及維修的要求不同,不能僅以體積縮小推論已具備軌道部署能力。
- 材料升級趨勢:Kessel 顯示高速互連可能帶動 PCB 材料向更低損耗規格發展,但實際需求仍取決於量產規模。
- 供應鏈驗證:應追蹤 SpaceX 官方公告、實際產品拆解、供應商出貨與財報,而非直接將產業情報視為確定訂單。
- 商業化關鍵:觀察量產良率、系統功耗、單位算力成本、實際部署規模及維護費用,才能判斷 Kessel 是否具備成本競爭力。
留言
留言載入中…